Next.js·리액트 SEO의 핵심은 구글이 렌더링하기 전에도 제목·본문·링크를 읽을 수 있게 만드는 것입니다. 구글은 자바스크립트를 실행해 페이지를 렌더링할 수 있지만, 구글 검색 센터 문서는 서버 측 렌더링이나 사전 렌더링이 “여전히 좋은 방법”이라고 안내합니다. 모든 크롤러가 자바스크립트를 실행하지는 않기 때문입니다. 리액트만으로 만든 단일 페이지 앱(SPA)이라면 주소 처리·상태 코드·메타 태그를 특히 신경 써야 합니다.
30초 요약
- 구글의 처리 순서: 크롤링 → 렌더링 → 색인
- Next.js: 서버 컴포넌트의
metadata·generateMetadata로 제목·설명, 파일 규칙으로 robots.txt·sitemap.xml - 리액트 SPA:
#/주소 대신 History API, 링크는<a href>, 없는 페이지는 404 또는 noindex - 확인: 서치콘솔 URL 검사의 ‘테스트된 페이지 보기’로 렌더링된 HTML 확인
구글은 자바스크립트 사이트를 어떻게 읽나요?
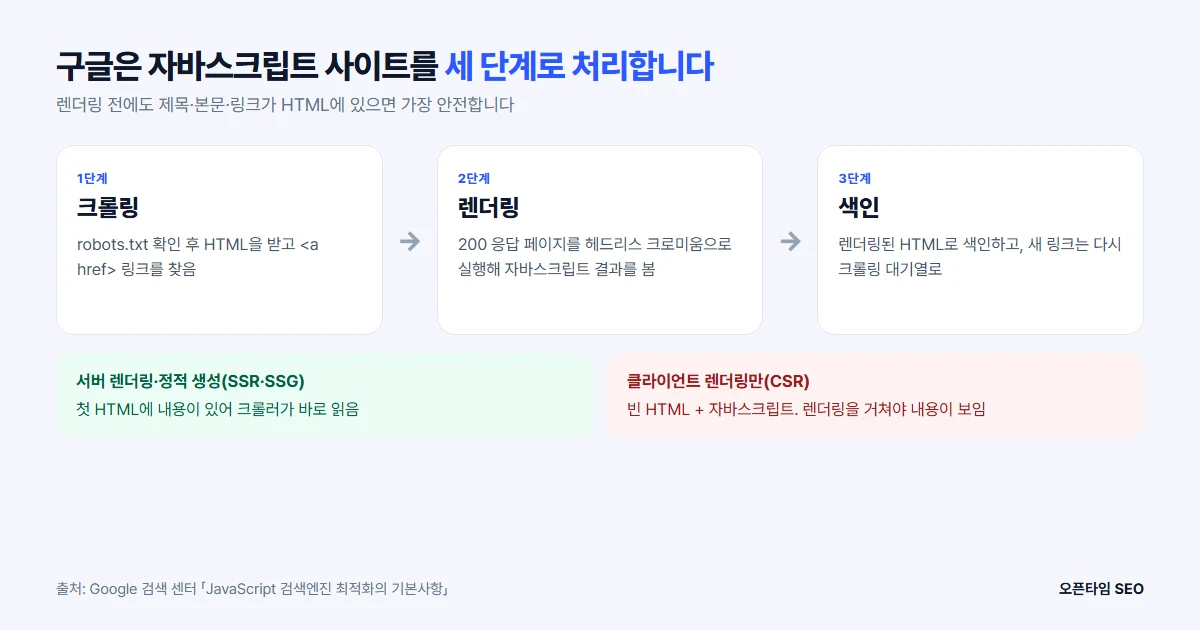
구글 검색 센터 「JavaScript 검색엔진 최적화의 기본사항」에 따르면 구글은 자바스크립트 웹 앱을 크롤링 → 렌더링 → 색인 세 단계로 처리합니다.
- 크롤링: robots.txt로 허용 여부를 확인한 뒤 HTML을 받고,
href속성이 있는 링크를 찾아 대기열에 넣습니다. robots.txt로 막힌 파일·페이지의 자바스크립트는 렌더링하지 않습니다. - 렌더링: noindex가 없는 200 응답 페이지를 렌더링 대기열에 넣고, 리소스가 허용되면 헤드리스 크로미움으로 자바스크립트를 실행합니다.
- 색인: 렌더링된 HTML로 색인하고, 새로 보이는 링크를 다시 크롤링 대기열에 넣습니다.
초기 HTML이 비어 있고 자바스크립트가 내용을 그리는 ‘앱 셸’ 방식은 렌더링을 거쳐야 내용이 보입니다. 그래서 첫 HTML에 내용이 들어 있는 서버 렌더링(SSR)·정적 생성(SSG)이 가장 안전합니다.
Next.js에서는 무엇을 설정하나요?
Next.js 공식 문서 「Metadata and OG images」 기준으로 정리했습니다(App Router).
| 항목 | 방법 | 주의 |
|---|---|---|
| 제목·설명(고정) | layout.js·page.js에서 export const metadata = { title, description } |
서버 컴포넌트에서만 지원 |
| 제목·설명(데이터 기반) | generateMetadata()에서 글 데이터를 가져와 반환 |
페이지와 같은 데이터는 React cache로 한 번만 요청 |
| robots.txt·sitemap.xml | app 폴더에 robots·sitemap 파일 규칙으로 정적·동적 생성 |
글이 늘어나면 동적 생성으로 |
| 공유 이미지 | opengraph-image.jpg 파일 또는 ImageResponse로 생성 |
더 깊은 폴더의 이미지가 우선 |
| 캐노니컬 | metadata의 alternates.canonical |
페이지마다 자기 정본 주소 |
동적으로 렌더링되는 페이지에서 Next.js는 메타데이터를 따로 스트리밍할 수 있는데, 공식 문서는 <head>에 메타데이터가 있어야 하는 봇에게는 이 스트리밍을 끈다고 설명합니다. 대상 봇 목록은 htmlLimitedBots 설정으로 조정할 수 있습니다.
리액트 SPA에서는 무엇을 조심하나요?
구글 문서가 꼽는 권장사항은 다음과 같습니다.
| 문제 | 구글 권장 |
|---|---|
#/products 같은 프래그먼트 주소 |
History API로 /products 같은 실제 주소를 사용. 구글은 프래그먼트 주소를 안정적으로 따라가지 못함 |
onClick만 있는 버튼형 링크 |
링크는 href가 있는 <a> 요소로. 그래야 구글이 링크를 발견 |
| 없는 상품인데 200 응답(soft 404) | 서버의 404 주소로 자바스크립트 리디렉션하거나, 오류 화면에 noindex 추가 |
| 페이지마다 같은 제목 | 자바스크립트로 페이지별 고유한 <title>·메타 설명 설정 |
| 캐노니컬을 자바스크립트로 바꿈 | HTML에서 지정하는 것이 가장 좋고, 원본 HTML의 캐노니컬을 다른 주소로 바꾸지 않음 |
| 오래된 JS·CSS가 렌더링에 쓰임 | main.2bb85551.js처럼 파일 이름에 내용 지문을 넣어 캐시 문제 방지 |
이미지 지연 로딩도 구글 가이드라인에 맞게 구현해야 합니다. 스크롤해야만 불러오는 방식이면 렌더링 시점에 이미지·글이 빠질 수 있습니다.
구글이 내 페이지를 제대로 보는지 어떻게 확인하나요?
- 서치콘솔 → URL 검사 → 실시간 URL 테스트 → 테스트된 페이지 보기에서 렌더링된 HTML과 스크린샷을 확인합니다.
- 렌더링된 HTML에 제목·본문·내부 링크가 모두 있는지 봅니다. 구글은 렌더링된 HTML에 보이는 내용만 색인합니다.
- 구조화 데이터는 리치 결과 테스트로 렌더링 후에도 남아 있는지 확인합니다.
- 브라우저에서 자바스크립트를 끄고 페이지를 열어, 첫 HTML에 무엇이 들어 있는지도 봐 두면 원인을 찾기 쉽습니다.
개발팀이 있는 Next.js·리액트 사이트라면 오픈타임 SEO가 렌더링·메타·사이트맵 점검 결과를 개발자가 바로 고칠 수 있는 목록으로 정리해 드립니다. 테크니컬 SEO 서비스 보기 →
자주 묻는 질문
리액트로 만든 사이트는 구글에 안 나오나요?
나올 수 있습니다. 구글은 최신 크로미움으로 자바스크립트를 실행합니다. 다만 렌더링 단계를 거쳐야 하고 다른 크롤러는 자바스크립트를 실행하지 않을 수 있어, 서버 렌더링이나 사전 렌더링을 함께 쓰는 것이 안전합니다.
Next.js를 쓰면 SEO가 자동으로 되나요?
Next.js는 서버 렌더링과 메타데이터 도구를 제공할 뿐입니다. 페이지별 제목·설명, 캐노니컬, 사이트맵, 404 처리는 직접 설정해야 하고, 콘텐츠와 링크 작업은 프레임워크와 관계없이 필요합니다.
클라이언트 렌더링 사이트를 다 바꿔야 하나요?
꼭 그렇지는 않습니다. 검색 유입이 필요한 페이지(서비스·글·상품)부터 서버 렌더링이나 정적 생성으로 바꾸고, 로그인 뒤 화면처럼 검색에 나올 필요가 없는 부분은 그대로 두는 방식이 현실적입니다.
참고: Google 검색 센터 「JavaScript 검색엔진 최적화의 기본사항 이해하기」, Next.js 문서 「Metadata and OG images」(2026-10-12 확인).